연구와 개발 경험을
모두 갖춘 AI 엔지니어

AI 모델 연구를 통해 문제를 정의하고 해결 방법을 탐구해 왔습니다. 나아가 연구 성과를 실제 서비스로 구현하고, 다양한 AI 기술을 하나의 시스템으로 연결하며 개발 역량을 확장했습니다.
이웅재 프로필 사진
8편학술 논문
2건특허 출원
3회제1저자 Oral

연구실 인턴에서 해외 학회 Oral 발표까지

연구실 인턴으로 AI 연구를 시작해 모델 개발과 실험을 경험했으며, 석사과정에서는 실환경 문제를 해결하기 위한 연구를 수행했습니다. 이후 연구 성과를 AI 서비스와 시스템으로 구현하며 개발 영역까지 경험을 확장해 왔습니다.

Education

숭실대학교 전자정보공학부 IT융합학과 학사

2017.03 – 2024.02

숭실대학교 일반대학원 정보통신공학과 석사

2024.09 – 2026.08 · 통신망보안연구실

학위논문 · 실환경 잡음에 강건성을 갖는 오디오 딥페이크 탐지 프레임워크 연구

R&D Experience

  • 경찰청 · 허위조작 콘텐츠 진위여부 판별 시스템 개발
  • 과학기술정보통신부 · 딥페이크 탐지 고도화·생성 억제·유포 방지 플랫폼
  • 과학기술정보통신부 · 위변조 음성에 강인한 화자 인증 모델

Research & Engineering Interests

ResearchAudio Deepfake Detection · Robust AI · Explainable AI · Audio Forensics

EngineeringAI Model Serving · AI System Integration · Model Deployment

Patents

  • 국내 · 노이즈 적응형 딥페이크 음성 탐지 시스템 (10-2025-0137328)
  • 미국 · Noise-Adaptive Audio Deepfake Detection and Method (19/432,349)
  1. 2023
    딥페이크 음성 탐지 연구실 인턴
    데이터셋 정리로 AI 연구를 처음 경험
  2. 2024.03
    숭실대학교 산학협력단 연구원 | AISRC
    딥페이크 음성 탐지 연구개발 · 데이터 전처리 · 모델 학습/평가 · 웹 애플리케이션 개발
  3. 2024.09
    숭실대학교 석사과정 입학
    ACM CCS 2024, CISC-W 2024 발표
  4. 2025
    국가 R&D 과제 3건 · 국내/미국 특허 출원
    멀티모달 통합 시스템 구축 · WildSpoof Challenge 2위 · 우수성과 100선
  5. 2026.05
    ICASSP 2026 제1저자 Oral 발표
    스페인 바르셀로나 · DNA Multi-LoRA
  6. 2026.08
    WISA 2026 제1저자 Oral 발표 · 석사 졸업
    FLEX 프레임 단위 설명 기법
  7. 2026.09 –
    숭실대학교 산학협력단 연구원 | AISRC
    딥페이크 음성 탐지 시스템 고도화 · 추론 API · Docker 배포·운영
2017 – 2023수상 2건

여러 분야를 거쳐 음성 AI로 학부 시절의 시도들

로봇 모션, 영상처리, 임베디드, 적정기술까지 분야를 가리지 않고 시도했고, 졸업작품에서는 딥러닝 모델과 서버·앱을 하나의 서비스로 완성했습니다. 이 경험이 2023년 딥페이크 음성 탐지 연구실 인턴으로 이어졌습니다.

2017.04 – 2017.08 · 팀원

SOC 태권로봇 경진대회

상대 로봇의 동작에 반응해 회피·공격·방어를 수행하는 휴머노이드 로봇. 관절 모터에 과부하가 걸리지 않는 범위에서 태권도 동작 모션을 설계하고 하드웨어를 관리했습니다.

로봇 모션 제어영상처리16팀 중 8위

2020.02 – 2020.11 · 팀장 · 영상처리 담당

SW 임베디드 소프트웨어 경진대회 수상

휴머노이드 로봇이 라인 트레이싱으로 이동하며 4개 미션 중 3개를 완료하는 과제. 컨투어·Convex hull로 방위와 화살표를 인식하고, HSV 마스킹과 면적 비율로 구역·미션 완료 여부를 판별하는 영상처리 전 과정을 맡았습니다.

OpenCV컨투어·HSV 마스킹Hough line 라인 트레이싱시연 영상 ↗

2021.07 – 2021.08 · 공모전

글로벌 적정기술 창의설계 프로젝트 장려상

안전·재해 분야의 사회적 약자를 위한 적정기술 공모전. 겨울철 폭설로 비닐하우스가 무너지는 피해를 줄이기 위해, 지붕에 눈이 쌓이는 것을 최소화하는 구조 아이디어를 제안했습니다.

적정기술재해 예방

2023.06 – 2023.11 · 졸업작품

RNN 기반 수어 번역 시스템

MediaPipe로 추출한 손 랜드마크 시퀀스를 LSTM으로 학습해 수어를 번역하고, Flask 서버(HTTP·Socket.IO)와 Flutter 앱을 직접 구축해 실시간으로 연동했습니다.

MediaPipeLSTMFlask · Socket.IOFlutterGitHub ↗
ICASSP 2026 · 제1저자 · Oral석사 연구국내·미국 특허

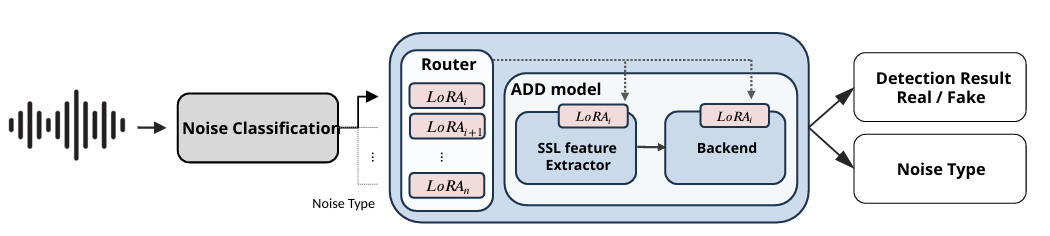
DNA Multi-LoRA 노이즈 인지 기반 동적 어댑터 적응 방법론

다양한 실환경 잡음으로 인해 저하되는 오디오 딥페이크 탐지 성능을 개선하기 위해, 입력 음성의 잡음 특성에 따라 탐지 모델을 효율적으로 적응시키는 방법을 제안했습니다.
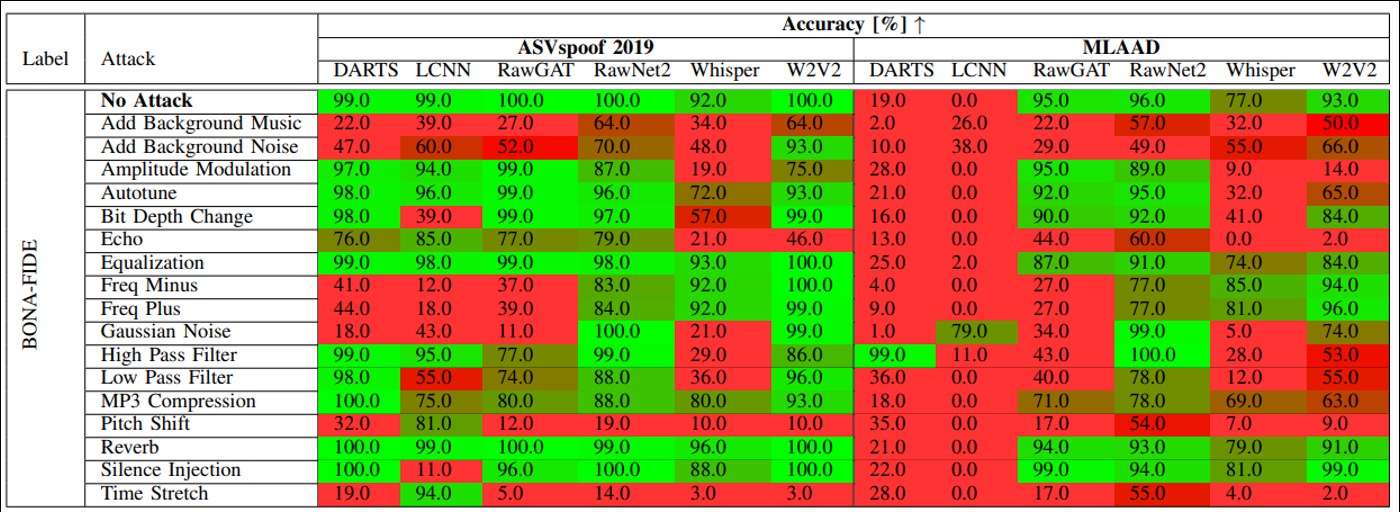
ASVspoof 2019와 MLAAD에서 6개 탐지 모델의 잡음·변형 조건별 정확도 히트맵
잡음·변형 조건별 탐지 정확도 · 대부분의 조건에서 크게 저하
DNA Multi-LoRA 구조도: 입력 음성 → 잡음 분류 → Router가 LoRA 선택 → 동결된 탐지 모델 → Real/Fake와 Noise Type 출력
구조 · 잡음 분류 → 어댑터 선택 → 진위 판별

Problem

기존 탐지 모델은 배경 소음·잔향·압축 등 실환경 조건에서 성능이 크게 저하되었습니다. 전체 모델을 재학습하는 방식은 학습 비용이 크고, 새로운 잡음 환경에 적응하는 과정에서 기존 성능이 저하될 수 있었습니다.

Approach

잡음 환경별 특성에 맞춰 모델을 효율적으로 적응시키기 위해, 잡음 유형별 LoRA 어댑터를 학습했습니다. 입력 음성의 Spectrogram·MFCC·F0 특징을 활용해 잡음 유형을 분류하고, 해당 환경에 적합한 어댑터를 선택해 동결된 탐지 모델에 적용했습니다.
DNA Multi-LoRA 실험 결과

41.4%평균 EER 상대 감소 · Baseline 대비
1/10학습 파라미터 · 26.7M vs 317.8M
95%잡음 분류 정확도
Result
두 백본 모두에서 Full Fine-tuning보다 낮은 EER을 기록했으며, 학습 파라미터를 약 91.6% 줄였습니다. 이를 통해 전체 모델을 재학습하지 않고도 다양한 잡음 환경에 효율적으로 적응할 수 있음을 확인했습니다.
WISA 2026 · 제1저자 · OralExplainable AI

FLEX 딥페이크 음성 탐지의 판단 근거를 프레임 단위로 설명하는 기법

Problem
기존 딥페이크 음성 탐지 모델은 진위 여부를 예측하지만, 음성의 어떤 구간이 판단에 영향을 미쳤는지 확인하기 어렵습니다. 이로 인해 탐지 결과를 해석하고 검증하는 데 한계가 있습니다.
Key Finding
발화 단위의 진위 레이블로 학습한 탐지 모델에서도, 내부 프레임 특징이 Real/Fake 클래스에 따라 서로 다른 분포를 형성한다는 점을 확인했습니다.
Approach
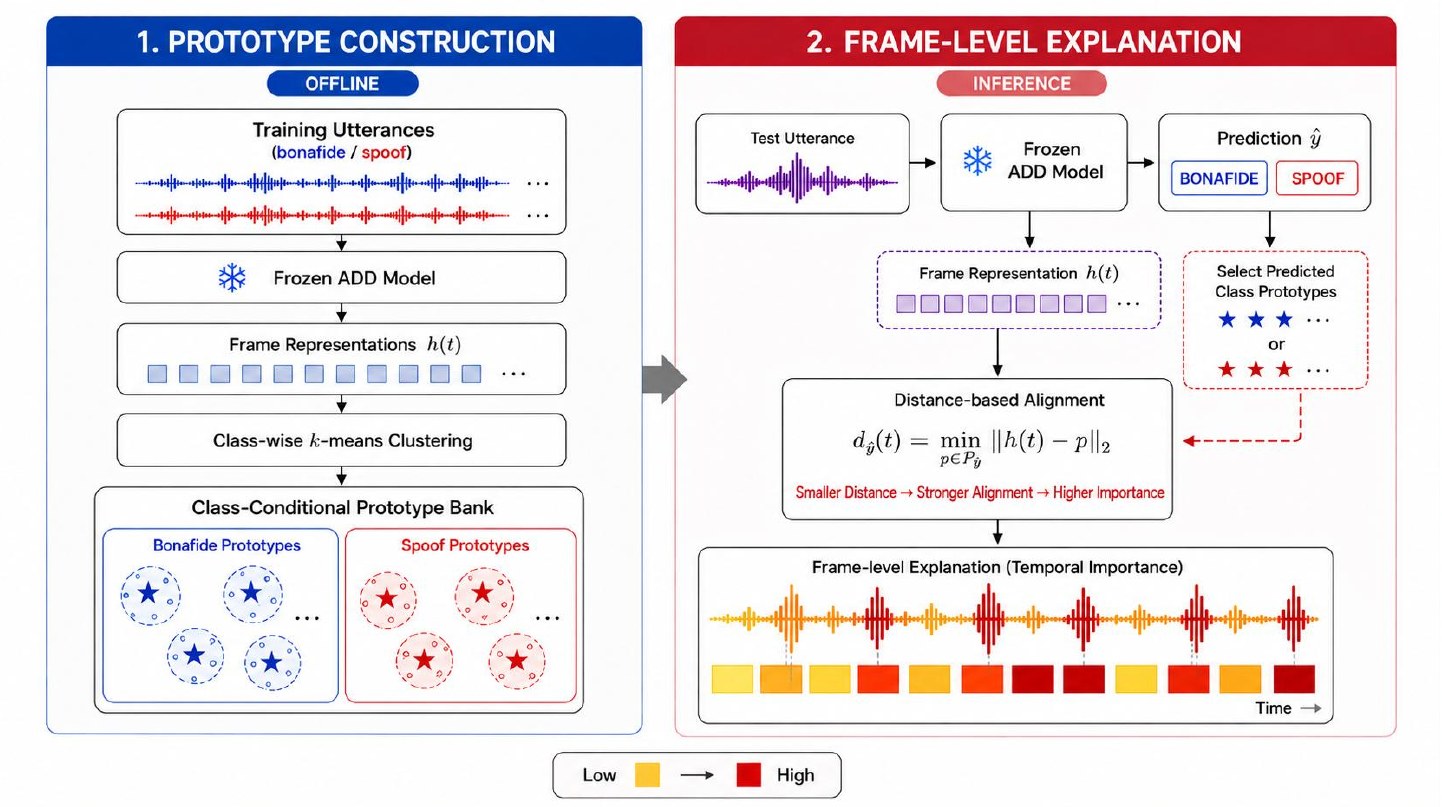
학습 데이터로 Real/Fake 클래스별 대표 특징(프로토타입)을 구성하고, 입력 음성의 각 프레임과 예측 클래스 프로토타입 간 거리를 계산했습니다. 이를 기반으로 프레임별 중요도를 산출해 탐지 판단에 기여한 구간을 설명하는 FLEX를 제안했습니다.
FLEX 구조: 1단계 학습 음성으로 클래스별 프로토타입 구성, 2단계 테스트 음성의 프레임 표현과 예측 클래스 프로토타입 간 거리로 프레임 중요도 계산

FLEX 실험 결과

1. 설명의 타당성 검증 마스킹 실험 EER (%) · 마스킹 전 7.85%

중요도가 높은 프레임을 제거하면 탐지 오류율이 증가하지만, 중요도가 낮은 프레임을 제거할 때는 성능이 상대적으로 유지됩니다.

10%20%30%
K (Kb/Ks)Pos ↑Neg ↓Pos ↑Neg ↓Pos ↑Neg ↓
2 (1/1)9.748.0316.587.8937.718.88
4 (2/2)9.497.8513.657.6428.759.35
8 (3/5)8.617.7710.997.4824.299.56
16 (4/12)8.777.7813.147.6831.819.28

3. 프레임 중요도 시각화

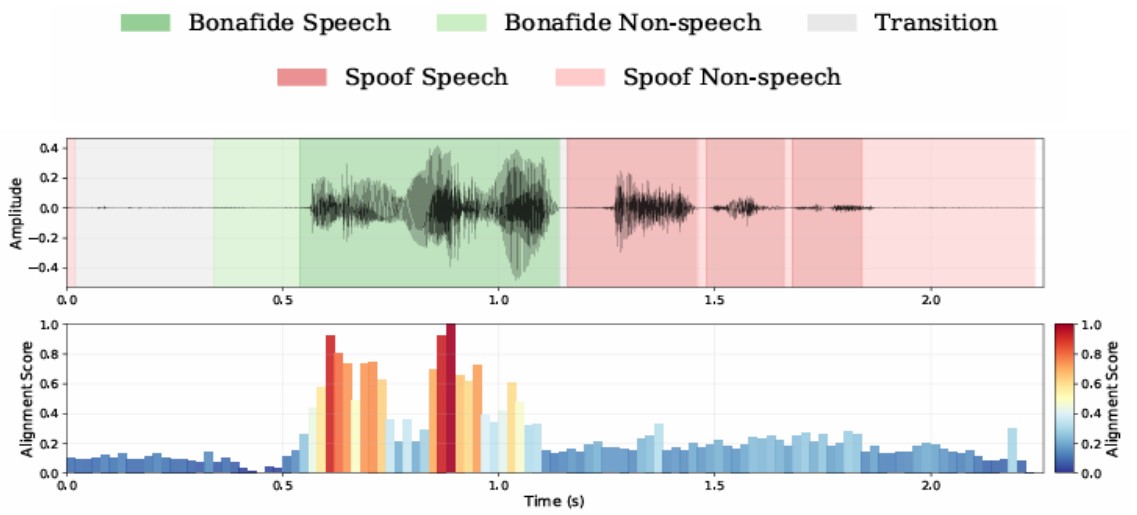
모델이 실제 음성으로 판단한 입력에 대한 FLEX 프레임 중요도: 실제 음성 구간에서 중요도가 높음

모델이 실제 음성(Bonafide)으로 판단한 예시입니다. 실제 음성 구간에 높은 중요도가 집중되고 위조·비음성 구간은 낮게 나타나, 모델이 실제 음성 구간을 근거로 판단했음을 보여줍니다.

Result
탐지 판단에 영향을 미치는 프레임을 효과적으로 설명하면서, 기존 기법보다 빠른 설명 생성 성능을 확인했습니다.
ICASSP 2027 · 제1저자 · 심사 중Audio Forensics

SAFE 음성이 포함된 녹음에서 녹음 환경을 분류하는 포렌식 기법

음성이 포함된 녹음에서 환경음 단서가 가려지는 문제를 해결하기 위해, 장면 분류에 필요한 특징은 보존하면서 음성의 영향을 줄이는 프레임워크를 제안했습니다.
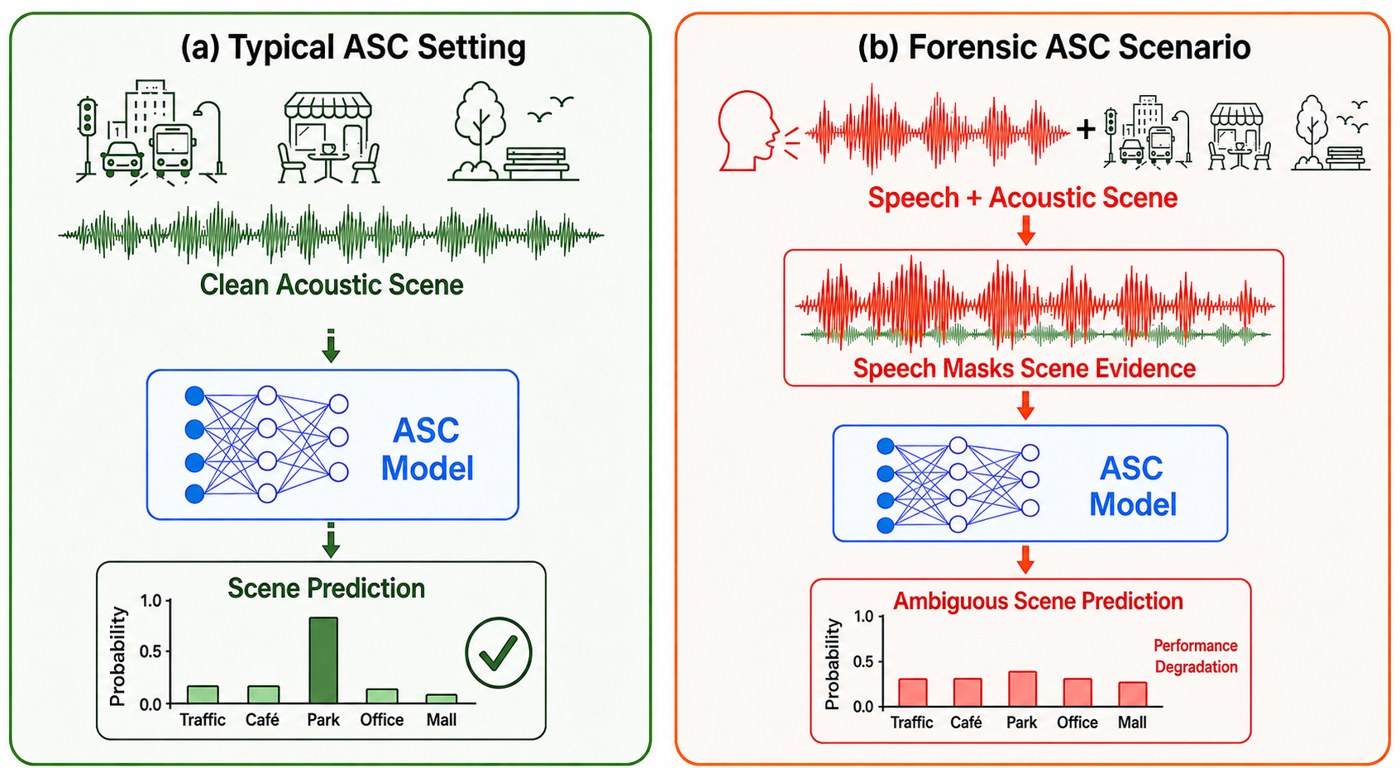
일반 ASC 환경과 포렌식 ASC 시나리오 비교: 음성이 장면 단서를 가려 장면 예측이 모호해짐
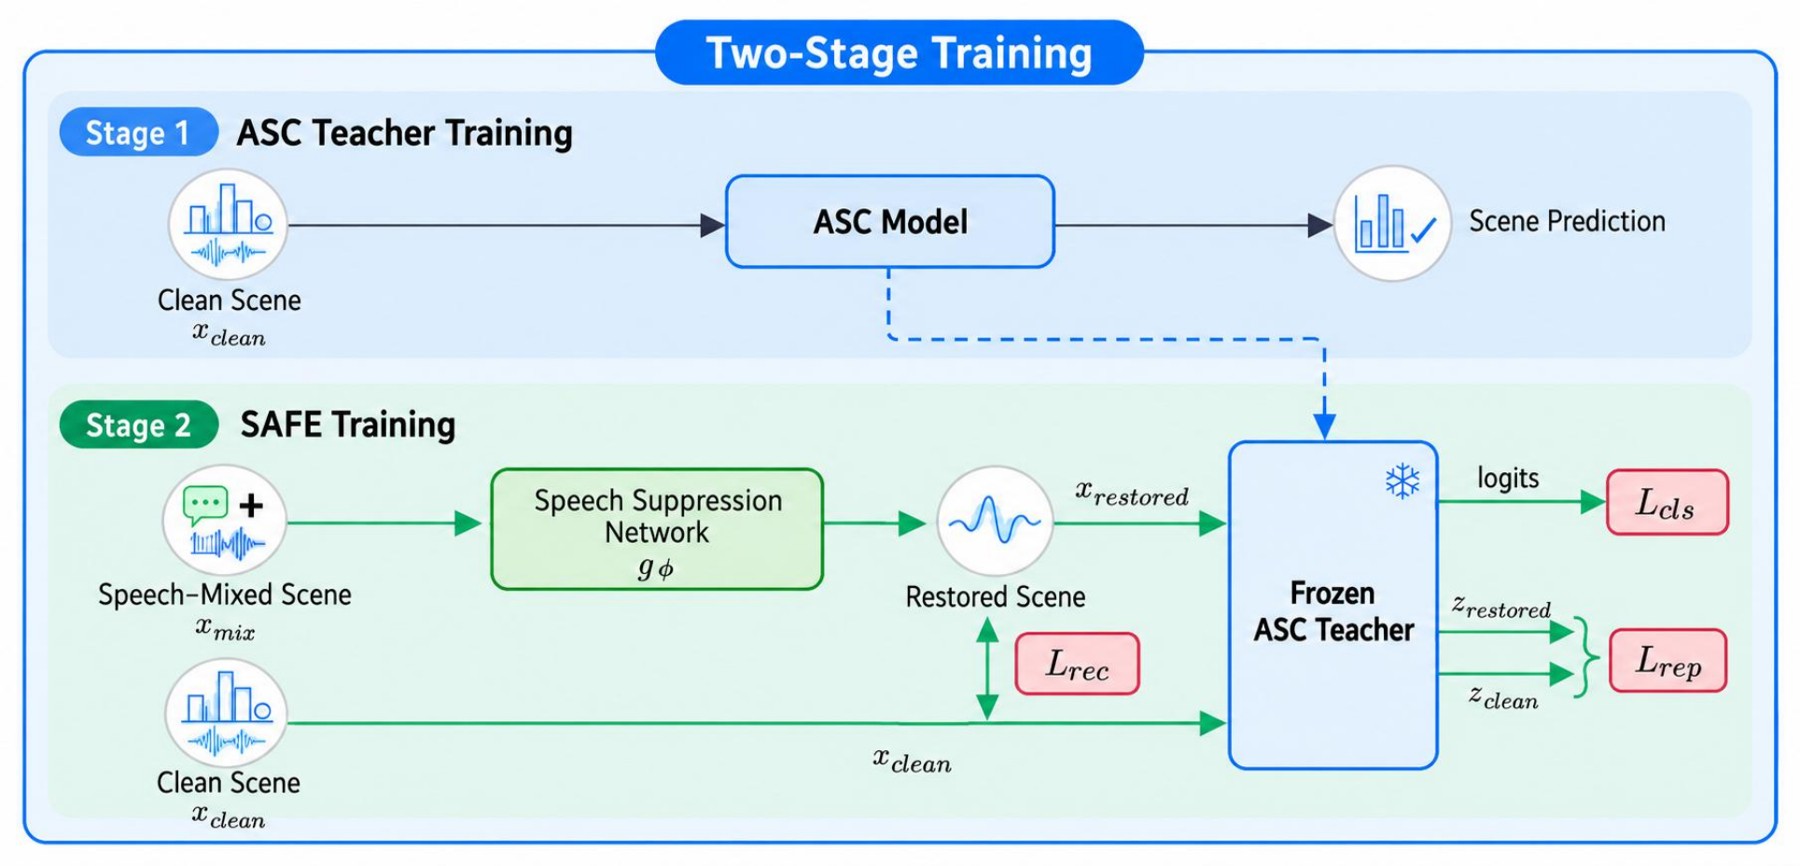
SAFE 2단계 학습 구조: 1단계 ASC 교사 학습, 2단계 교사 지도 음성 억제 학습
구조 · 1단계 분류 교사 학습 → 2단계 교사 지도 음성 억제 학습

Problem

음성이 포함된 녹음에서는 발화가 주변 환경음과 중첩되어 녹음 장소를 구분하는 단서가 가려집니다. 이로 인해 기존 음향 장면 분류 모델의 성능이 저하될 수 있습니다.

Approach

음성이 없는 환경음으로 학습한 장면 분류 모델을 교사 모델로 활용했습니다. 이후 음성 억제 네트워크가 음성의 영향을 줄이면서도 환경 분류에 필요한 특징을 유지하도록, 신호 복원과 특징 보존 및 분류 목적을 함께 고려해 학습했습니다.
SAFE 실험 결과

68.3 → 81.0한국어 기반 환경 F1 · Baseline 대비 +12.7
56.3 → 68.6영어 기반 환경 F1 · Baseline 대비 +12.3

다른 음성 제거 기법은 한쪽 환경에서 오히려 성능이 떨어졌지만, SAFE는 두 환경 모두에서 가장 크게 향상했습니다.

음성 제거·억제 기법 비교 · SBR 10 dB · macro-F1 (%)

SBR(Speech-to-Background Ratio) 10 dB 조건에서 음성이 포함된 환경음의 분류 성능 비교 · F1이 높을수록 우수

Method한국어 기반 환경영어 기반 환경
Baseline
억제 미적용68.356.3
음성을 추정해 빼는 방식
MossFormer2-SE76.9 (+8.6)45.4 (−10.9)
Demucs33.3 (−35.0)11.0 (−45.4)
장면 신호를 복원하는 방식
Liu et al.74.4 (+6.1)41.8 (−14.6)
SAFE (Ours)81.0 (+12.7)68.6 (+12.3)
Result
한국어·영어 기반 평가 환경 모두에서 기존 기법보다 높은 분류 성능을 달성했습니다. 이를 통해 음성의 영향을 줄이면서 환경 분류에 필요한 특징을 보존하는 방법의 효과를 확인했으며, 향후 녹음 환경 분석이 필요한 오디오 포렌식 분야에 활용할 가능성을 제시했습니다.

논문 및 학술 성과

전체 목록은 Google Scholar에서 확인할 수 있습니다.

  • ACM CCS 2024

    Trident of Poseidon: A Generalized Approach for Detecting Deepfake Voices

    공동저자강건성딥페이크 탐지ACM DL ↗
  • CISC-W 2024

    Grad-CAM을 이용한 딥페이크 음성 탐지 시스템의 결정 설명

    제1저자Oral설명가능성딥페이크 탐지학회 페이지 ↗
  • 한국음향학회 2025

    음성 변형 추적: 강건한 음성 처리를 위한 노이즈 분류 접근법

    제1저자9월 특별호강건성논문 PDF ↗
  • 3D-SEC 2025

    Defending Speaker Verification Against Deepfake: A Multi-Step Approach

    공동저자화자 인증딥페이크 탐지ACM DL ↗
  • ICASSP 2026

    Dynamic Noise-Aware Multi-LoRA Framework towards Real-World Audio Deepfake Detection

    제1저자Oral강건성딥페이크 탐지IEEE Xplore ↗Scholar ↗
  • ICASSP 2026 WildSpoof

    Robust SASV System in Real-World Scenarios: A Fusion Approach for the WildSpoof Challenge

    공동저자Challenge 2위화자 인증딥페이크 탐지IEEE Xplore ↗
  • WISA 2026

    FLEX: Frame-Level Explanations for Trustworthy Audio Deepfake Detection

    제1저자Oral설명가능성딥페이크 탐지학회 프로그램 ↗
  • 3D-SEC 2026

    Explaining Suspicious Speech Beyond Binary Deepfake Detection: A Five-Module Proposition-Centered Evidence Profile

    공동저자오디오 포렌식딥페이크 탐지ACM DL ↗
  • ICASSP 2027

    SAFE: A Speech Suppression-Based Acoustic Scene Classification Framework for Environmental Evidence in Audio Forensics

    제1저자Under Review오디오 포렌식
N사 기술이전 · 약 1억 6,500만 원방송 시연우수성과 100선

딥페이크 음성 탐지 서비스 웹 서비스 개발 및 On-Premise 배포

Problem
연구 모델은 연구실 서버의 스크립트로만 실행할 수 있었으며, 반복 시연 과정에서는 연속 요청에 따른 GPU 메모리 증가와 추론 지연 문제가 발생했습니다.
Approach
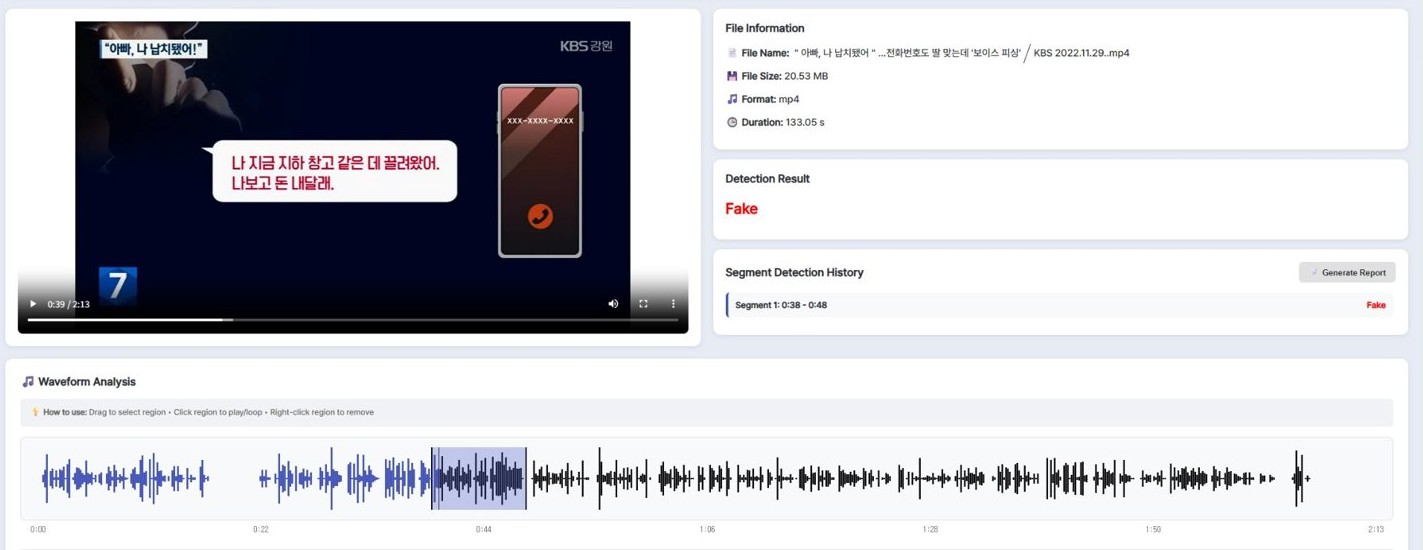
음성·영상 업로드부터 음성 추출, 모델 추론, 구간별 결과 시각화까지 이어지는 웹 서비스를 구축했습니다. 이후 추론 기능을 별도 API로 분리하고 모델 로딩 구조를 개선해 반복 호출에 대응했으며, Docker 기반 실행 환경을 구성해 기업의 On-Premise 환경에 배포할 수 있도록 했습니다.
Result
개발한 시스템을 KBS·MBC·MBN·SBS 방송과 국내외 전시에서 반복 시연했으며, 기업 환경에서 활용할 수 있도록 패키징하여 기술이전에 기여했습니다.
딥페이크 음성 탐지 대시보드 화면: 영상 업로드, 파일 정보, Fake 판정, 구간별 탐지 이력, 파형 분석
뉴스 영상 속 보이스피싱 음성을 분석한 화면
시연 영상 (57초) · 업로드 → 탐지 결과 → 구간 선택 탐지
경찰청 R&D · 2025.04 – 2027.12주관 숭실대학교 산학협력단연세대 · 성균관대 · ㈜한컴위드 참여

허위조작 콘텐츠 진위여부 판별 시스템 개발 사이버수사지원 기술개발 R&D

딥페이크 영상·딥보이스·AI 생성 뉴스 탐지와 원천 추적 기술을 고도화하고, 이를 MLOps 기반 통합 탐지 시스템으로 묶어 경찰 수사 현장에 적용하는 과제입니다. 이 중 음성 탐지와 1차 통합 시스템을 맡았습니다.
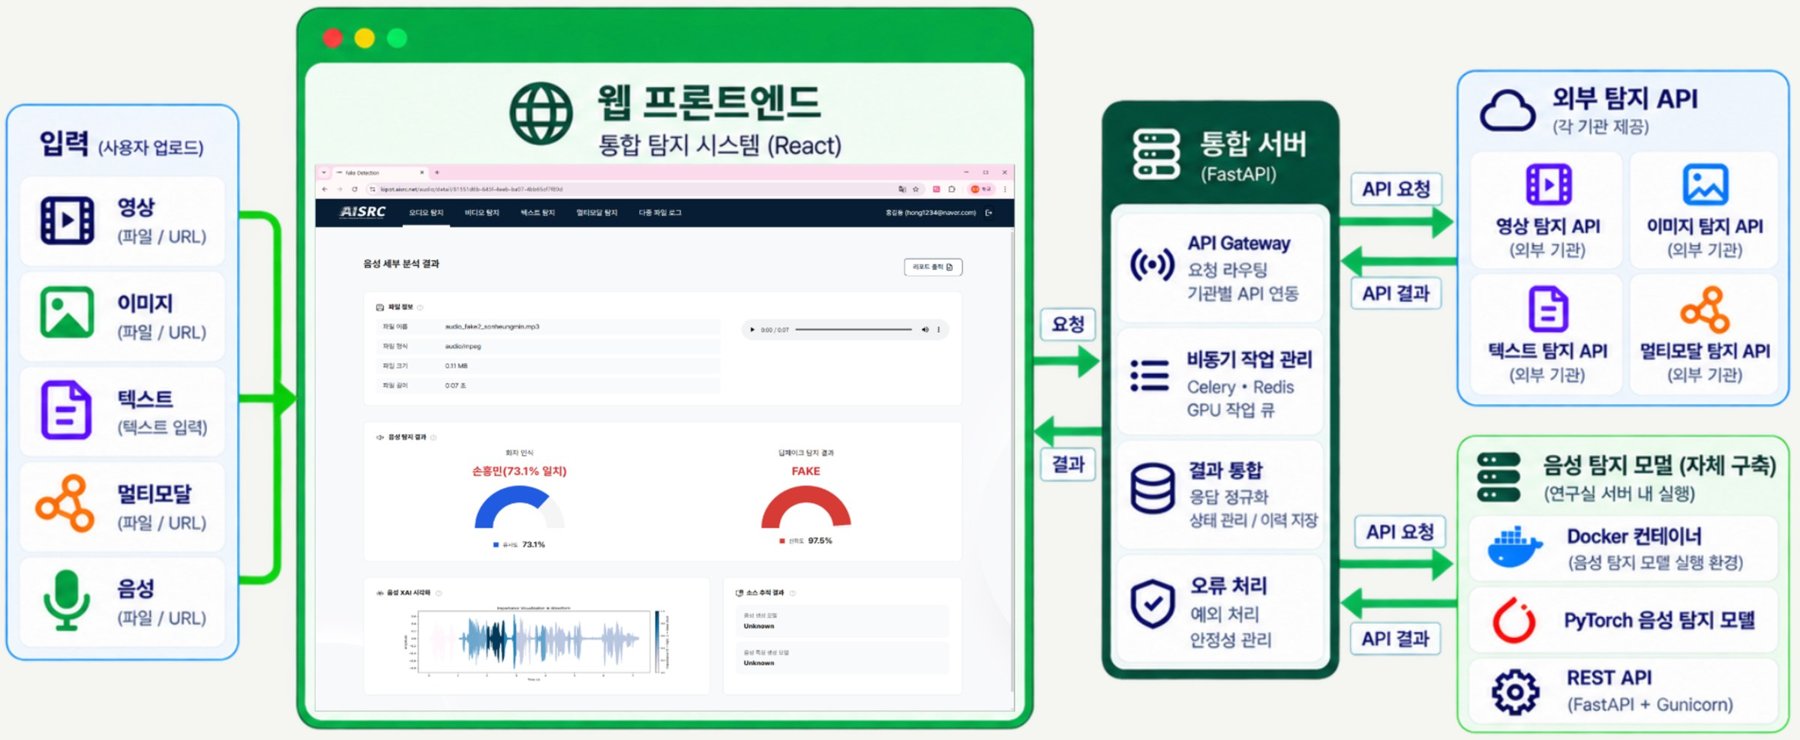
모델 고도화
딥보이스 탐지 모델을 실환경 잡음·압축 조건에 강건하도록 개선하고, 한국어 데이터로 성능을 검증했습니다.
API 개발
통합 시스템이 바로 호출할 수 있도록 음성 탐지 추론 API를 개발하고 Docker로 패키징해 제공했습니다.
통합 시스템
기관별 탐지 API의 입출력 조건과 변경 이력을 문서화해 공통 인터페이스로 연결하고, 영상·음성·이미지·텍스트 탐지 결과를 한 화면에서 종합하는 1차 통합 탐지 시스템을 구축·관리했습니다.
보고·조율
연차·단계 보고서와 발표자료를 작성하고, 기업의 On-Premise 이전 과정에서 기관별 수정 사항과 연동 일정을 조율했습니다.
통합 시스템 구조: 사용자 입력 → React 프론트엔드 → FastAPI 통합 서버 → 외부 기관 탐지 API와 자체 음성 탐지 모델
1차 통합 탐지 시스템 구조 · 프론트엔드, 통합 서버, 기관별 탐지 API, 자체 음성 탐지 모델
Result
1차 통합 탐지 시스템을 구축해 과제 데모로 운영했으며, 구축된 시스템은 독일 LKA에 제공되었습니다.
개인 프로젝트로컬 LLMRAG

ResearchOS 연구 자동화 파이프라인

매일 최신 논문을 모아 로컬 LLM으로 요약하고, 지식 그래프와 벡터 DB로 정리해 의미 기반으로 검색할 수 있게 만든 개인 연구 파이프라인입니다.

Why
최신 논문을 수집하고 읽은 내용을 정리하는 반복 작업에 많은 시간이 소요되어, 연구 자료의 수집부터 요약·검색까지 자동화할 필요가 있었습니다.
How
arXiv와 OpenAlex에서 논문을 수집하고, 로컬 LLM으로 내용을 요약한 뒤 지식 그래프와 벡터 DB에 저장하는 파이프라인을 구축했습니다. 전체 과정을 매일 자동 실행하도록 구성해 외부 LLM API 비용 없이 운영하고 있습니다.
Output
오디오 딥페이크 탐지 관련 논문 1,400편 이상을 13개 주제와 연도별로 분류한 공개 목록을 구축했습니다.

수상 및 대외 활동

2025 · 과학기술정보통신부

국가연구개발 우수성과 100선

참여 연구단의 실시간 딥페이크 음성 탐지 기술 개발 및 상용화 성과 선정

2025.12

WildSpoof Challenge 2위

실환경 딥페이크 탐지·화자 인증 국제 챌린지 팀 2위

2025 · 과학기술정보통신부

LAB Start-up 전시부문 우수

참여 연구단의 AI 기술 사업화 가능성 인정

기술 전시 및 현장 시연

  • ITRC 인재양성대전 2024~20263년 연속 AI·음성 보안 기술 전시 및 시연
  • INTERSPEECH 2024·2025
    ICASSP 2025·2026
    국제학회 전시 부스에서 AI 탐지 기술 시연 및 연구 내용 설명
  • GPEC 2026 독일경찰청 R&D 통합 시스템 시연 및 현지 관계자와 기술 교류
  • 방송 시연KBS·MBC·MBN·SBS 방송에서 개발 시스템을 활용한 딥페이크 음성 탐지 시연

국제학회 발표 및 기술 교류

  • ICASSP 2026 · 스페인DNA Multi-LoRA 연구 제1저자 Oral 발표
  • WISA 2026FLEX 연구 제1저자 Oral 발표
  • INTERSPEECH 2026 · 호주국제학회 참가 및 최신 음성 AI 연구 동향 파악
  • 기타 학회 및 기술 행사ICASSP 2025 · CES 2025 · KubeCon 2025 참관
Home01 / 13